Git의 버전관리시스템(VCS)의 이해
새솔CRM을 매일 만지면서도 정작 “Git이 왜 이렇게 설계되었는가”는 명령어 뒤에 가려져 있었다. 오늘은 그 뿌리 하나를 제대로 파봤다 — 델타(변경분) 기반 버전관리와 Git의 스냅샷 기반 버전관리가 근본적으로 무엇이 다른지, 그리고 그 차이가 브랜치와 병합(merge), 그리고 fast-forward까지 어떻게 하나로 이어지는지. 까먹을까 봐, 오늘 이해한 흐름 그대로 기록해둔다.
1. 시작은 “그림 하나가 이해가 안 됐다”였다
Pro Git 책의 한 대목을 읽다가 막힌 게 있었다. CVS, Subversion 같은 종전 VCS(버전관리시스템)와 Git의 차이를 설명하는 부분인데, “종전 시스템은 파일의 변화를 시간순으로 기록하고, Git은 데이터를 파일 시스템 스냅샷의 연속으로 취급한다”는 문장이었다.
언뜻 보면 둘 다 “바뀐 부분만 기록해서 저장을 아낀다”는 점에서 비슷해 보였다. 그런데 책은 이걸 두고 Git이 “완전히 다른 관점”이라고 강조한다. 뭐가 다르다는 건지 하나씩 뜯어봤다.
2. 종전 VCS: 저장 단위는 “파일별 변경 이력(델타)”
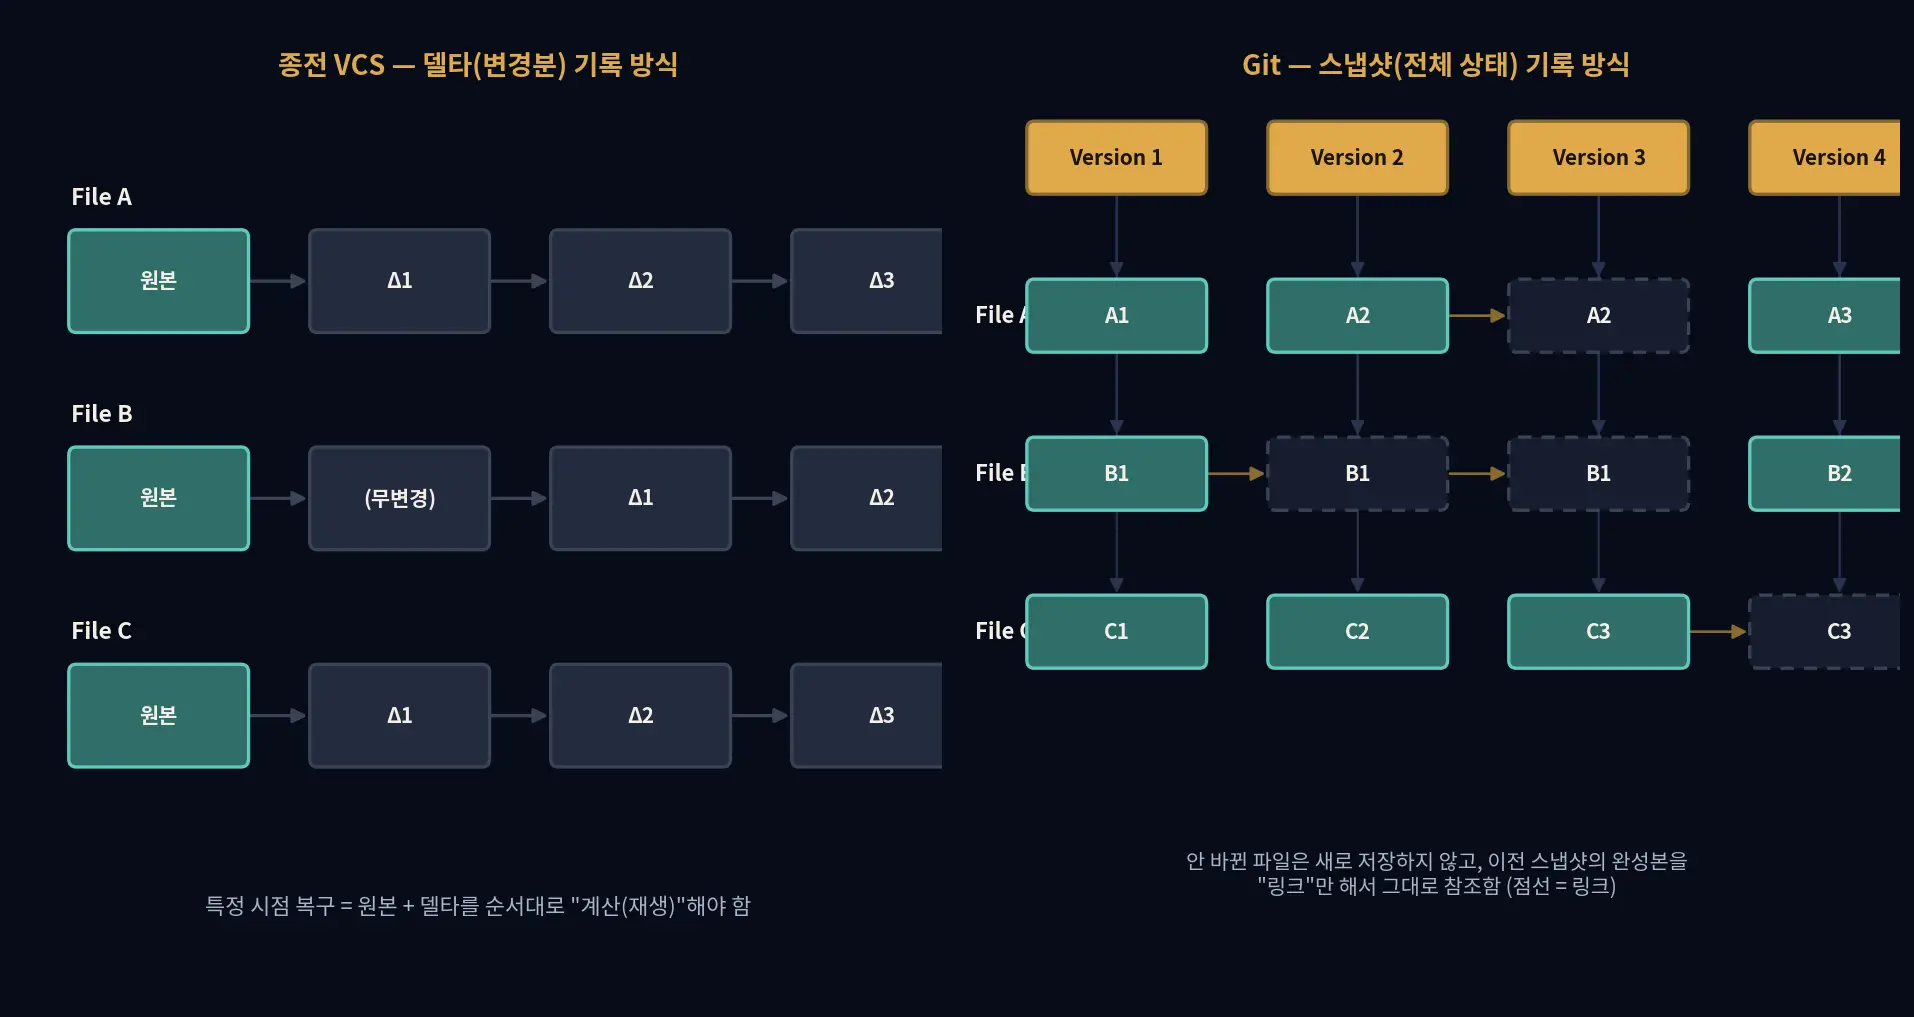
CVS나 Subversion 같은 시스템은 파일 하나하나를 독립적으로 추적한다. 파일 A는 원본에서 시작해서 Δ1(변경분1), Δ2(변경분2)… 이런 식으로 자기만의 역사(타임라인)를 따로 갖는다. 파일 B, 파일 C도 각자 별도의 변경 이력을 쌓는다.
여기서 중요한 건 “버전 N”이라는 게 디스크에 완결된 실체로 존재하지 않는다는 점이다. 버전3의 파일 A 내용을 알고 싶으면, 원본에서 시작해서 Δ1을 적용하고 Δ2를 적용하는 계산(재생) 과정을 거쳐야 비로소 그 시점의 실제 내용이 나온다. “버전”이라는 건 이 델타들의 조합으로 매번 재구성해야 하는 가상의 결과물인 셈이다.
3. Git: 저장 단위는 “그 순간 프로젝트 전체의 상태(스냅샷)”
Git은 커밋할 때마다 “이 순간 프로젝트 전체가 어떤 모습인가”를 하나의 단위로 찍는다. 버전1은 (A, B, C) 전체 세트, 버전2는 (A1, B, C1) 전체 세트 — 이런 식이다. 여기서 B가 안 바뀌었다면, Git은 B를 새로 저장하지 않고 이전 스냅샷의 B를 가리키는 링크만 남긴다.
처음엔 이 부분이 종전 시스템의 델타 방식과 비슷해 보여서 헷갈렸다. “결국 링크를 따라가서 예전 걸 가져오는 거 아닌가? 그럼 종전 방식이랑 뭐가 다르지?” 하는 의문이었다.
종전 VCS의 링크는 변경분(Δ)을 가리킨다. 그 지점부터 계산(재생)을 시작해야 완성된 내용이 나온다.
Git의 링크는 이미 완성된 파일 전체 내용을 가리킨다. 그 링크를 따라가면 그대로 읽어서 쓰기만 하면 끝이다.
비유하자면 이렇다. 종전 VCS는 “3층 방 모습이 궁금하면 1층 설계도를 보고 2층에서 바뀐 부분을 반영하고 3층에서 바뀐 부분을 또 반영해서 머릿속으로 그려보라”는 방식이고, Git은 “3층 방 사진이 여기 있다. 못 하나도 안 바뀐 벽은 2층 사진이랑 똑같은 파일이니 그거 그대로 갖다 쓰면 되는데, 그 사진 자체가 이미 완성된 3층 전체 사진”이라는 방식이다.
| 종전 VCS (델타 기반) | Git (스냅샷 기반) | |
|---|---|---|
| 저장하는 것 | 파일별 변경분(Δ) | 그 순간 전체 상태(스냅샷) |
| “버전 N”의 실체 | 가상 — 델타를 계산해야 나옴 | 실제 — 이미 완성된 객체로 존재 |
| 특정 버전 얻는 법 | 파일마다 델타 재생(연산 필요) | 트리 포인터 따라가기(연산 불필요) |
저장되는 데이터의 총량만 놓고 보면 사실 두 방식이 크게 다르지 않을 수도 있다. 진짜 차이는 “복구할 때 뭘 해야 하느냐”에 있다. 종전 시스템은 매번 델타를 순서대로 조립(계산)해야 하고, Git은 이미 완성되어 있는 스냅샷을 그대로 참조만 하면 된다.
4. 이 차이가 브랜치를 “가볍게” 만든다
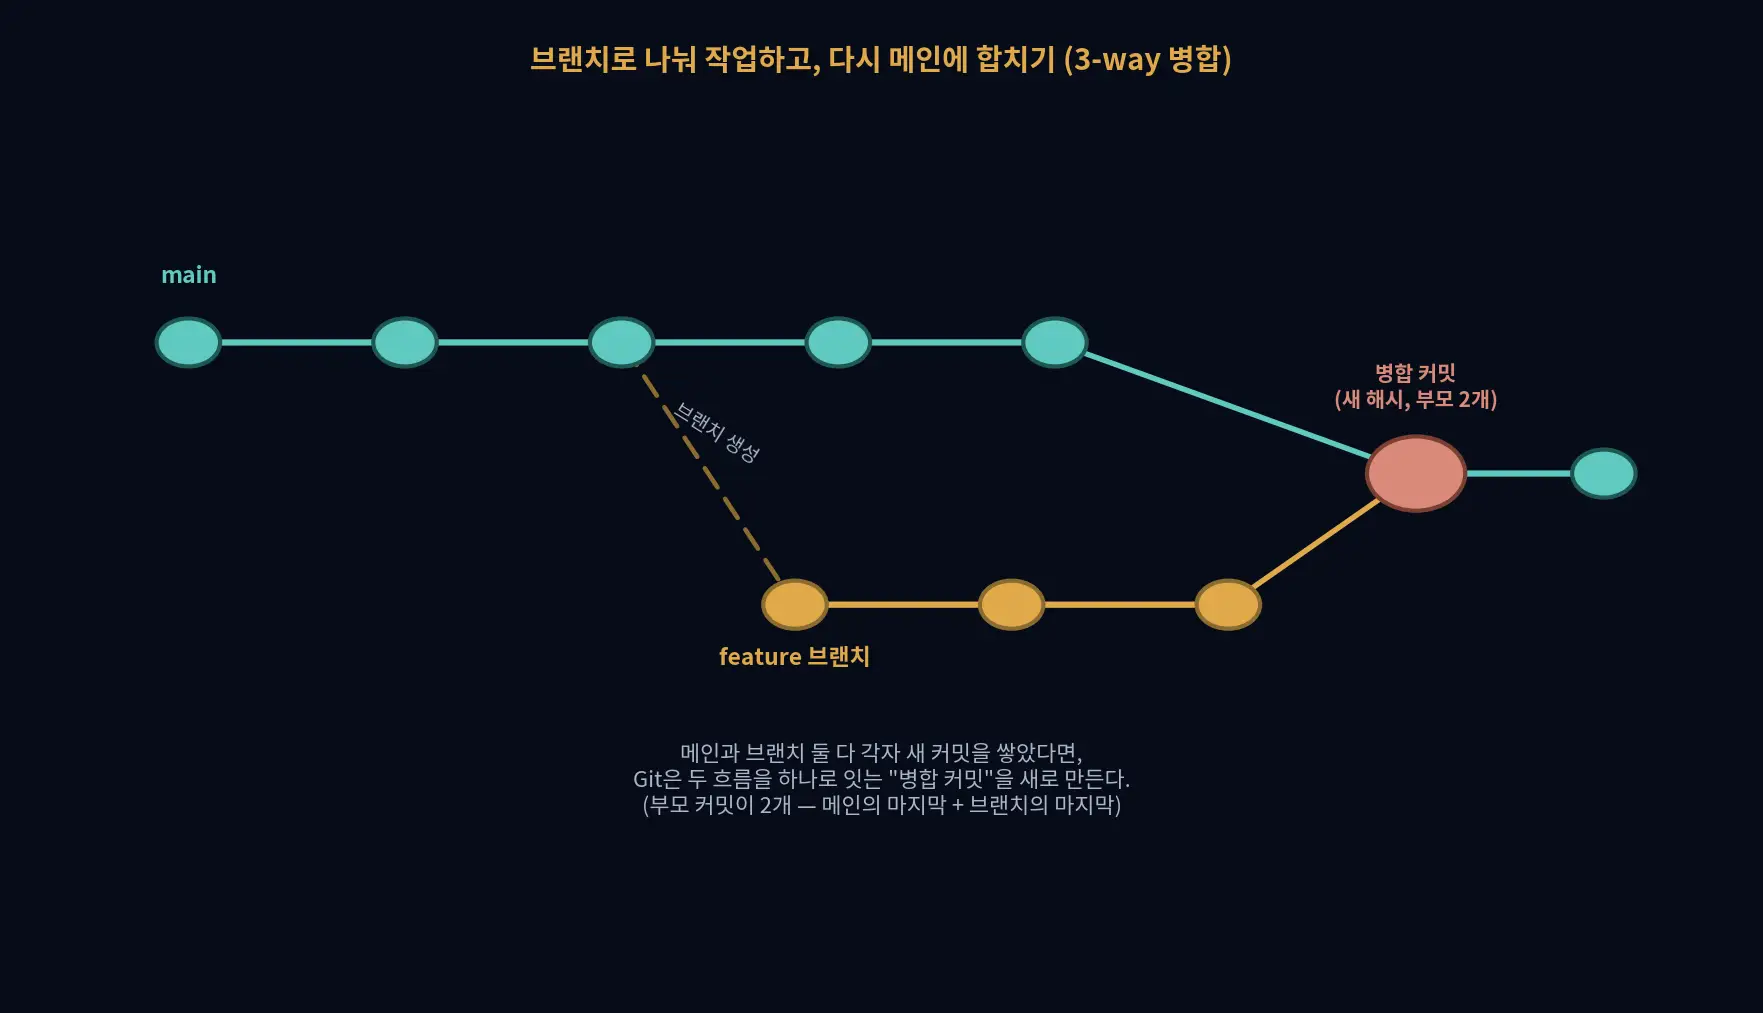
Git의 브랜치는 사실 대단한 게 아니다. 특정 커밋을 가리키는 이름표(포인터)일 뿐이다. `feature-branch`를 만드는 순간, 그 브랜치는 “지금 이 커밋에서 시작한다”는 표시만 남기고 메인과 별도로 커밋을 쌓아나간다.
새솔CRM처럼 처음엔 기능이 몇 개 안 될 때는 메인 하나로 죽 이어가도 괜찮지만, 큰 기능 하나를 새로 붙일 때 메인에서 바로 작업하면 자칫 메인 자체가 불안정해질 위험이 있다. 그럴 때 브랜치를 따로 만들어 독립적으로 버전관리를 하다가, 기능이 완성되면 메인에 합치는(병합하는) 흐름이 훨씬 안전하다.
병합할 때 커밋 해시는 어떻게 될까
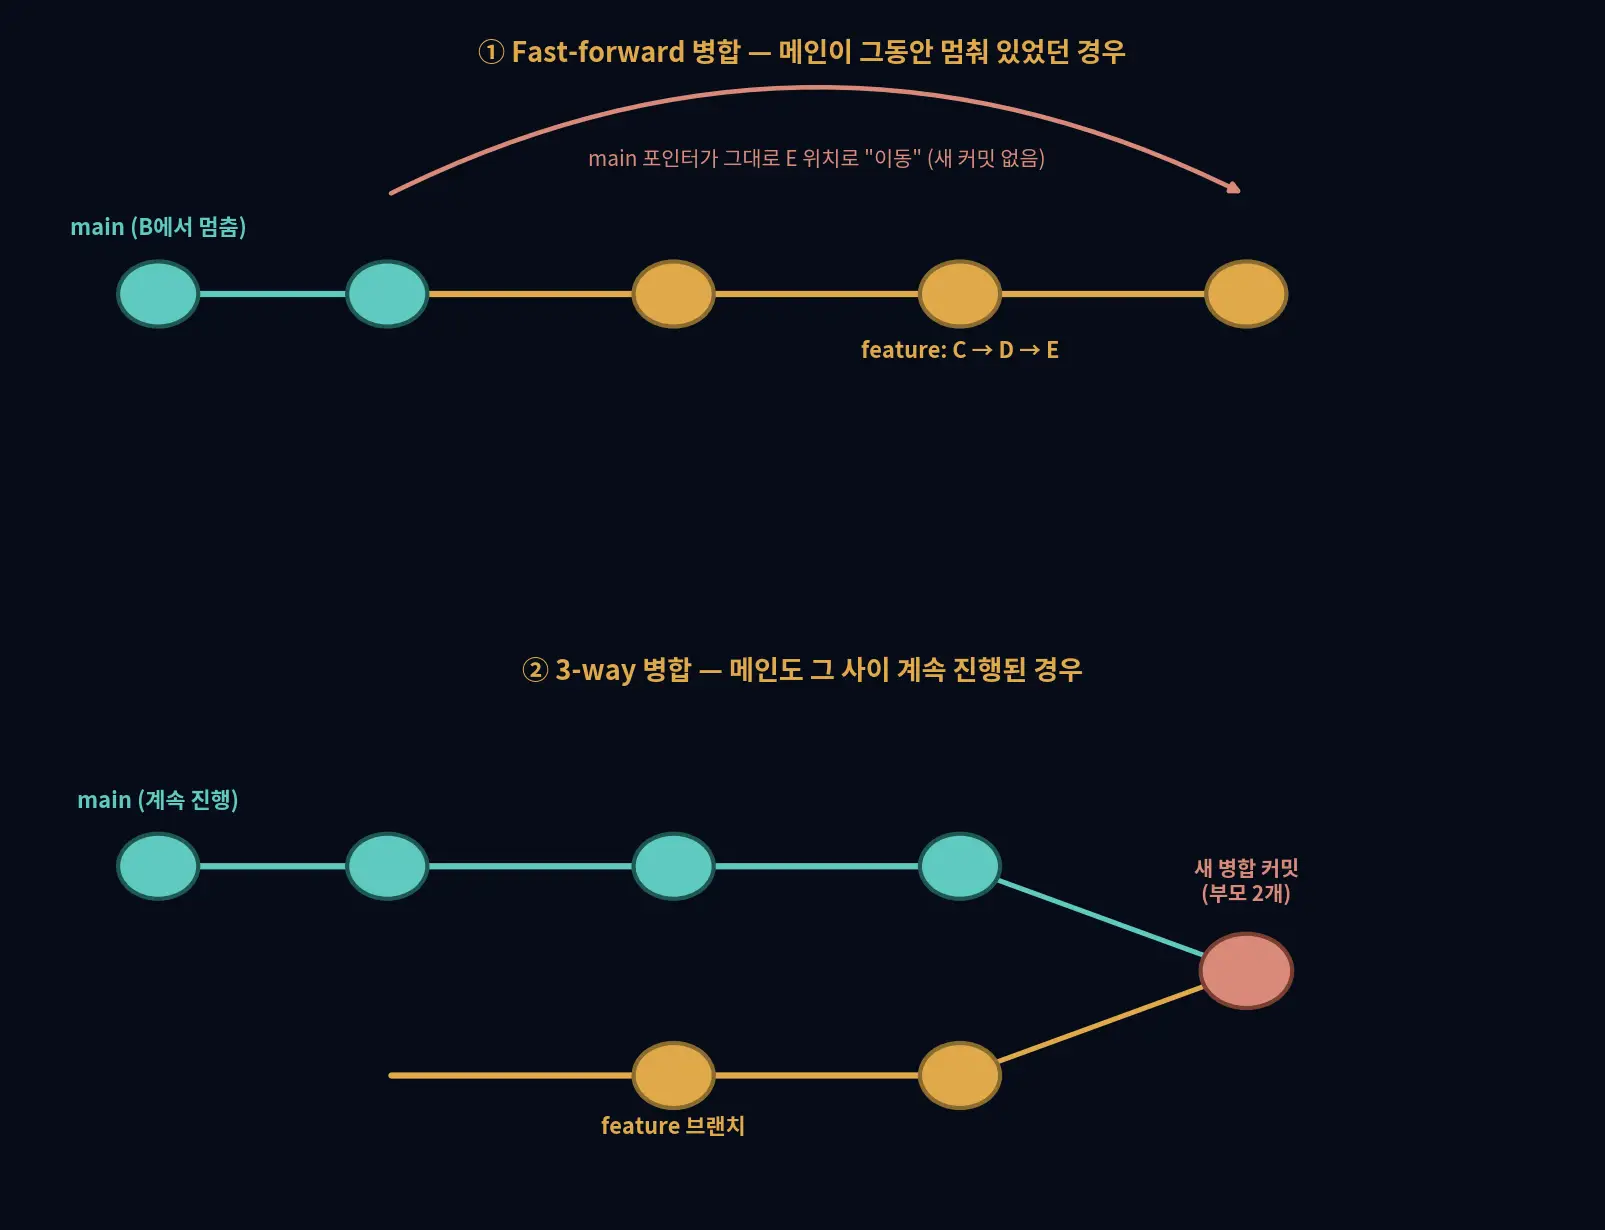
메인과 브랜치가 각자 새 커밋을 쌓은 상태(양쪽 다 진행된 상태)에서 합치면, Git은 새로운 “병합 커밋(merge commit)”을 하나 생성한다. 이 커밋은 새로운 고유 해시값을 가지며, 부모(parent) 커밋이 2개다 — 메인의 마지막 커밋과 브랜치의 마지막 커밋.
기존 커밋들의 해시가 바뀌는 게 아니라, “이 둘을 합쳤다”는 걸 나타내는 새 커밋 하나가 그 위에 추가로 얹히는 개념이다. 메인 이력과 브랜치 이력은 그대로 다 보존된다.
5. Fast-forward — “빨리 감기”처럼 합쳐지는 경우
병합에는 또 하나의 케이스가 있다. 만약 브랜치를 딴 이후로 메인 쪽에 아무 변경이 없었다면, Git은 새 병합 커밋을 만들 필요 없이 메인이라는 이름표(포인터)를 브랜치의 마지막 커밋 위치로 그냥 이동시켜버린다.
메인이 브랜치를 “흡수”하는 게 아니라, 메인이라는 이름표 자체가 브랜치가 이미 도달해 있던 지점까지 걸어가서 그 자리에 서는 것에 가깝다. 이 경우 새로운 커밋이 생기지 않고, 브랜치의 기존 커밋 해시들이 그대로 메인의 이력이 된다. 병합했다는 흔적(병합 커밋)조차 남지 않는다.
왜 이게 “가능”한가 — 결국 스냅샷 구조 덕분이다
여기서 오늘 대화의 모든 조각이 하나로 이어졌다. 만약 종전 VCS(델타 기반) 방식이었다면, “메인을 브랜치의 마지막 시점으로 옮긴다”는 건 파일 하나하나마다 그 구간의 델타를 순서대로 계산해서 적용해야 최종 상태가 나오는 작업이다. 파일이 많으면 많을수록 이 재생 과정 자체가 무겁다.
반면 Git은 애초에 브랜치의 각 커밋이 이미 완성된 스냅샷으로 존재한다. 그러니 메인을 그 지점으로 옮긴다는 건 “계산해서 만들어내는” 게 아니라, 이미 만들어져 있는 완성품을 가리키기만 하면 끝나는 일이다. 포인터 하나만 슥 옮기면 되니 순식간이고, “빨리 감기(fast-forward)”라는 이름이 정확히 그 뜻을 담고 있다.
6. 오늘 이해한 것을 한 줄로 정리하면
- 각 커밋이 그 자체로 완결된 상태다 (재생·계산이 필요 없다)
- 그래서 브랜치를 만들고 옮겨다니는 게 그냥 “포인터 이동”이라 가볍다
- 그래서 fast-forward도 “포인터만 이동”으로 순식간에 끝난다
처음 그림 하나를 보면서 “이게 종전 방식이랑 뭐가 다르다는 거지” 하고 막혔던 질문이, 결국 브랜치의 가벼움과 fast-forward의 원리까지 전부 설명해주는 근본 이유였다. 표면적으로 명령어를 외운 게 아니라 뿌리부터 연결해서 이해했다는 게, 오늘 대화에서 가장 남는 소득이다.
실전에 이렇게 연결된다
새솔CRM 워크플로우에서 git fetch origin && git reset --hard origin/main을 돌릴 때
왜 파일별로 하나씩 되돌리는 게 아니라 전체가 한 번에 그 시점 상태로 딱 맞춰지는지도 같은 원리다.
그 커밋(스냅샷) 하나가 이미 “그 순간 프로젝트 폴더 전체를 찍은 사진”이기 때문에, 그 사진 위치로
포인터를 옮기기만 하면 로컬 전체가 그 모습 그대로 재현되는 것이다.
7. 그런데 왜 모든 VCS가 다 Git처럼 바뀌지 않았을까
여기까지 이해하고 나니 자연스럽게 드는 의문이 있었다. 스냅샷 방식이 이렇게 효율적이라면, 왜 Perforce나 SVN 같은 델타(중앙집중형) 시스템들은 여전히 남아있는 걸까. 완전히 밀려나서 사라졌어야 하는 거 아닐까 — 하고. 찾아보니 여기엔 두 가지 짚고 넘어갈 지점이 있었다.
사실 Git도 “순수 스냅샷”만 쓰는 건 아니다
먼저 전제부터 다시 봐야 했다. Git이 커밋 단위로는 분명 스냅샷 모델을 쓰지만, 그걸 디스크에
영구 저장할 때는 git gc(가비지 컬렉션) 과정에서 packfile이라는 걸 만들면서
내부적으로 델타 압축을 적용한다. “이 파일이 지난 스냅샷과 비슷하니 차이만 압축해서 저장하자”는 걸
백그라운드에서 나중에 하는 것이다.
그러니까 정확히는 이렇다 — 작업 단위(개념 모델)는 스냅샷이지만, 저장 효율화(압축)는 델타 기법을 빌려 쓴다. 두 방식이 완전히 대립하는 게 아니라, Git은 “스냅샷으로 다루되 저장할 땐 델타로 압축”하는 일종의 하이브리드에 가까웠다.
그럼에도 델타/중앙집중형 방식이 여전히 살아남는 이유
소스코드처럼 텍스트 파일이 자잘하게 바뀌는 경우엔 Git 방식이 압도적으로 유리하다. 하지만 2GB짜리 비디오 파일에서 1KB만 바뀌는 상황이라면, 매번 그 파일 전체를 “새 스냅샷”으로 저장하는 건 굉장히 비효율적이다. 이런 영역(게임 개발 등)에서는 여전히 Perforce 같은 중앙집중형 델타 시스템이 표준으로 쓰인다.
바이너리 파일(포토샵 psd, 3D 모델 등)은 텍스트처럼 “병합(merge)”이 안 된다. 두 사람이 동시에 같은 파일을 고치면 그냥 파일이 깨진다. 그래서 “내가 지금 이 파일 작업 중이니 다른 사람은 못 건드리게 잠금”이 필요한데, 이건 중앙집중형 시스템이 훨씬 자연스럽게 지원한다. Git 같은 분산형 모델은 애초에 이런 잠금 개념이 약하다.
SVN 같은 시스템은 “이 폴더는 A팀만, 저 폴더는 B팀만” 식으로 디렉토리 단위 접근 권한을 세밀하게 걸기가 쉽다. Git은 저장소 전체 단위로 권한을 주는 게 기본이라(요즘은 GitHub·GitLab이 우회 기능을 제공하지만), 대규모 조직의 복잡한 권한 요구사항에는 SVN류가 더 잘 맞는 경우가 있다.
이미 수십 년 치 SVN 이력이 쌓인 대기업 레거시 시스템을 Git으로 옮기는 건 비용과 리스크가 크다. “더 나은 기술”이 있어도 전환 비용이 그걸 상쇄하는 경우가 흔하다.
| Git이 유리한 영역 | 델타·중앙집중형이 유리한 영역 | |
|---|---|---|
| 파일 성격 | 텍스트, 소스코드 | 대용량 바이너리 |
| 협업 방식 | 브랜치 + 병합 | 파일 잠금 |
| 조직 요구 | 분산·오픈소스 친화 | 세밀한 경로별 권한 통제 |
새솔CRM은 전형적으로 Git이 압도적으로 유리한 영역(Node.js 텍스트 소스코드)이라, 지금 워크플로우가 정확히 맞는 선택이었다는 것도 확인된 셈이다. 다만 나중에 대용량 PDF나 이미지 자산을 많이 버전관리해야 하는 상황이 생긴다면, 그 부분만 Git LFS(Large File Storage) 같은 보조 도구를 곁들이는 게 낫다는 점은 기억해두자.
비전공자로 2026년 1월부터 새솔CRM을 처음부터 만들어오면서, 오늘에서야 비로소 Git의 근본 원리 하나를 제대로 붙잡은 느낌이다. — vibe coding 여정, 오늘의 기록.